

Um "bad block" (ou setor defeituoso) é uma área de armazenamento em um disco rígido (HDD) ou unidade de estado sólido (SSD) que não é mais confiável para gravar ou ler dados. Para mapeá-los hoje, a recomendação técnica é monitorar os atributos S.M.A.R.T. do disco (especificamente os atributos 5 e 197), em vez de usar varreduras de sistema operacional. Um disco com bad blocks ainda pode ser usado com segurança se o número de setores remapeados pela controladora de hardware permanecer estável ao longo do tempo; no entanto, um aumento contínuo e rápido nesses números indica falha iminente e exige a substituição imediata da unidade.
Principais Aprendizados
- O mapeamento é autônomo: Em SSDs e HDDs modernos, a própria controladora do disco detecta e substitui bad blocks usando áreas de reserva invisíveis ao sistema operacional.
- Estabilidade é a chave: A presença de um bad block não condena o disco imediatamente; o perigo real é o crescimento contínuo de setores defeituosos, indicando degradação em cascata.
- Evite scans de superfície em SSDs: Comandos como
chkdsk /rconsomem ciclos de gravação desnecessários em SSDs, reduzindo sua vida útil sem trazer benefícios reais de recuperação física.
O Que São Bad Blocks e a Mudança de Paradigma
Historicamente, em discos rígidos magnéticos (HDDs), um bad block representava um dano físico na superfície do prato magnético (um arranhão, por exemplo) ou um erro lógico grave de gravação. O usuário dependia de ferramentas do sistema operacional para varrer a superfície e marcar esses setores como inutilizáveis no sistema de arquivos.
Com a transição para as unidades de estado sólido (SSDs), o conceito evoluiu. Em SSDs, os bad blocks são frequentemente o resultado do desgaste natural das células de memória NAND Flash após atingirem seu limite de ciclos de programa/apagamento (P/E cycles). O mapeamento moderno ocorre de forma quase invisível: a controladora de hardware do próprio disco gerencia os erros, utilizando áreas de reserva (conhecidas como Over-provisioning) para substituir blocos desgastados sem a intervenção do usuário.
Como Identificar e Mapear Setores Defeituosos
O consenso da área de TI aponta que monitorar a saúde do disco via S.M.A.R.T. (Self-Monitoring, Analysis, and Reporting Technology) é superior a rodar varreduras de superfície pelo sistema operacional. A controladora de hardware reconhece o estado físico do disco muito antes do sistema operacional.
Atributos S.M.A.R.T. Cruciais
Para avaliar a saúde da mídia, dois indicadores são fundamentais:
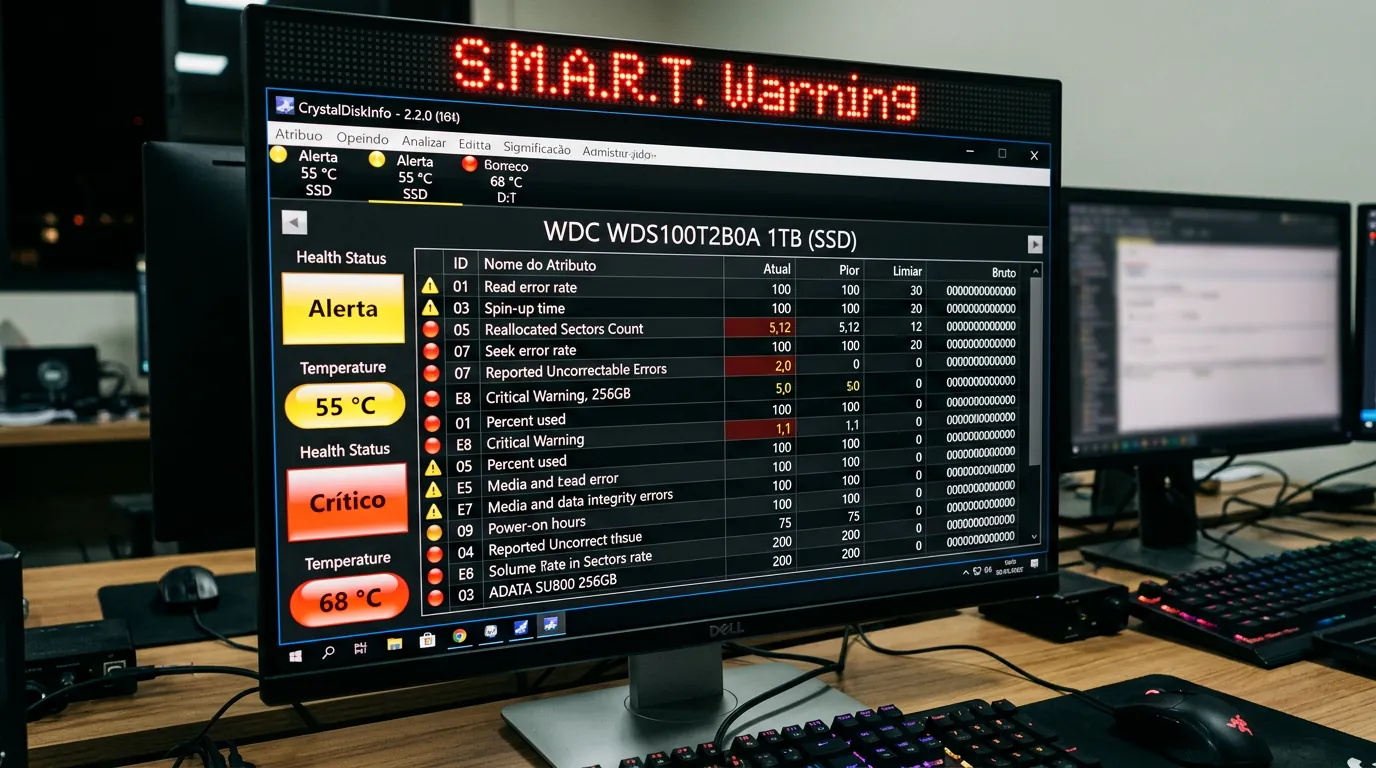
- Atributo 197 (Current Pending Sector Count): Aponta setores "instáveis" que a controladora tentou ler, mas falhou. O setor fica em espera. Se uma gravação subsequente for bem-sucedida, ele volta a ser saudável; se falhar, é remapeado. Segundo documentação da ULINK DA Drive Analyzer, este é um indicador primário de instabilidade.
- Atributo 5 (Reallocated Sectors Count): Representa a contagem de setores defeituosos que já foram permanentemente isolados e substituídos por setores da área de reserva. Um aumento contínuo neste valor é um dos preditores mais fortes de falha iminente de hardware.
O Papel do CHKDSK no Windows
O utilitário nativo do Windows trata bad blocks em nível de sistema de arquivos. Conforme a documentação da Microsoft, o parâmetro chkdsk /f corrige apenas erros lógicos. Já o chkdsk /r faz a varredura física tentando recuperar dados legíveis. No entanto, a aplicação do chkdsk /r em SSDs modernos é considerada desnecessária e prejudicial, pois gera Write Amplification (amplificação de gravação), consumindo a vida útil do drive.
Quando o Disco Ainda Dá Para Usar?
A dúvida mais comum surge após o diagnóstico inicial: o disco deve ser descartado imediatamente?
Estabilidade vs. Falha em Cascata
Todo disco rígido e SSD sai de fábrica com bad blocks registrados em sua lista primária (P-List). O que determina a viabilidade de uso contínuo é a estabilidade dos novos erros (registrados na G-List ou Grown Defect List). Se o S.M.A.R.T. acusa, por exemplo, 5 setores remapeados e esse número permanece inalterado por meses, a unidade está estável e ainda pode ser usada, desde que o usuário mantenha backups atualizados. Se o número sobe semanalmente, o disco entrou em uma falha em cascata e deve ser substituído imediatamente.
O Fim da Vida Útil em SSDs
Para prolongar a vida útil, as controladoras de SSD utilizam algoritmos de Wear Leveling (nivelamento de desgaste), distribuindo as operações uniformemente pelas células de memória. Além disso, reservam uma porcentagem da capacidade total (frequentemente entre 7% e 11%, segundo publicação no MDPI Sensors Journal) para o Over-provisioning, fornecendo blocos sobressalentes.
Quando esse pool de reserva se esgota e a controladora não consegue mais remapear bad blocks, SSDs com firmware bem projetado entram em modo "somente leitura" (read-only). Isso impede a corrupção do sistema de arquivos e permite o backup final dos dados antes da falha total.
Mitos Comuns sobre Recuperação de Bad Blocks
A tentativa de "consertar" discos defeituosos gerou diversos mitos no mercado de tecnologia:
- "Formatar o disco conserta bad blocks": A formatação, mesmo a completa (zero-fill), não repara danos físicos. Ela apenas força a controladora a identificar os setores defeituosos e substituí-los pela área de reserva. O dano físico permanece.
- "Softwares de regeneração salvam o disco": Ferramentas que prometem consertar bad blocks físicos (como antigos regeneradores de HDD) são altamente controversas. A avaliação técnica sênior indica que esses softwares apenas forçam a controladora a remapear o setor através de repetidas tentativas de leitura e gravação, criando uma falsa sensação de segurança em um hardware moribundo.
- "O CHKDSK recupera totalmente os dados do bad block": O utilitário tenta mover o que restou para um setor bom, mas se o dano físico for severo, os dados originais daquele bloco específico já estarão irremediavelmente corrompidos ou perdidos.
Perguntas Frequentes
O que causa bad blocks em um SSD?
Em SSDs, os bad blocks são causados principalmente pelo desgaste natural das células de memória NAND Flash, que possuem um número limitado de ciclos de programa/apagamento. Após atingirem esse limite, as células perdem a capacidade de reter dados com segurança.
Devo usar o CHKDSK em um SSD para procurar bad blocks?
Na prática, não é recomendado usar o comando chkdsk /r em SSDs. A controladora de hardware do SSD já gerencia os bad blocks nativamente. Rodar varreduras de superfície causa gravações desnecessárias, reduzindo a vida útil da unidade devido ao fenômeno de Write Amplification.
Se o meu disco acusar 1 bad block, devo trocá-lo imediatamente?
Não necessariamente. O fator decisivo é a estabilidade. Se o número de setores remapeados (Atributo S.M.A.R.T. 5) permanecer estável ao longo do tempo, o disco ainda pode ser usado com cautela e backups em dia. Se o número crescer continuamente, a falha é iminente e a troca deve ser imediata.
Fontes
- ULINK DA Drive Analyzer — https://ulink-da.com/smart-197-current-pending-sector-count/
- Zendesk ULINK Help Center — https://ulink.zendesk.com/hc/en-us/articles/360053005391-SMART-197-Current-Pending-Sectors-Count
- Microsoft Learn / Documentation — https://learn.microsoft.com/en-us/windows-server/administration/windows-commands/chkdsk
- MDPI (Sensors Journal) — https://www.mdpi.com/1424-8220/23/1/1
- DriveSavers Data Recovery — https://drivesaversdatarecovery.com/blog/what-is-wear-leveling/
- Rossmann Repair Group — https://rossmanngroup.com/what-happens-when-nand-cells-wear-out/
- Tom's Hardware Forums — https://forums.tomshardware.com/threads/hdd-smart-errors-197-and-198-count-went-from-20-to-0-zero-after-wipe-and-reformatting-can-i-use-the-drive.3702000/
- FreeBSD.org (Mailing Lists) — https://forums.freebsd.org/threads/smart-error-197-current-pending-sector.71761/
- Unraid.net (Community Forums) — https://forums.unraid.net/topic/167733-smart-197-current-pending-sector-count/
- The SSD Guy — https://thessdguy.com/how-controllers-maximize-ssd-life-better-wear-leveling/


0 Comentários