

Apenas um pequeno grupo de atributos SMART realmente indica que um disco rígido vai falhar: em HDDs, os valores brutos maiores que zero nos atributos 5 (Setores Realocados), 187 (Erros Incorrigíveis Reportados), 188 (Timeout de Comando), 197 (Setores Pendentes) e 198 (Incorrigíveis Offline) são fortes preditores de falha iminente. Para SSDs, o monitoramento muda de falhas mecânicas para o desgaste das células de memória, focando em atributos como Wear Leveling Count e Erase Fail Count. O status genérico de "Saudável" frequentemente mascara a degradação física real do componente.
Principais Aprendizados
- Tolerância Zero: Qualquer valor acima de zero nos atributos 5, 187, 197 ou 198 em um HD exige backup imediato.
- A Regra dos 5: Dados da Backblaze mostram que mais de 76% dos discos que falham apresentam erros prévios em pelo menos um de cinco atributos específicos.
- O Ponto Cego: Cerca de 36% dos discos morrem subitamente sem registrar nenhum alerta SMART prévio.
A Origem do S.M.A.R.T. e Seu Ponto Cego
A tecnologia S.M.A.R.T. (Self-Monitoring, Analysis, and Reporting Technology) surgiu em 1992 nos arrays de disco IBM 9337, originalmente sob o nome Predictive Failure Analysis (PFA). O objetivo da indústria era criar um padrão aberto para monitorar a degradação gradual dos discos de armazenamento. Contudo, há um limite técnico inerente ao sistema: ele monitora o desgaste, mas não prevê eventos catastróficos.
Dados históricos indicam que cerca de 36% dos discos rígidos que falham o fazem sem registrar nenhum erro prévio nos atributos SMART, conforme registros da Wikipedia sobre o padrão S.M.A.R.T.. Picos de tensão, falhas eletrônicas repentinas na placa lógica ou danos no motor do eixo (o spindle) podem matar a unidade instantaneamente. Nesses casos de falha mecânica súbita, entender que um HD fazendo barulho requer desligamento imediato é muito mais crítico do que tentar ler um relatório de software.
Os 5 Atributos Críticos em HDDs (A Regra da Backblaze)
Existem mais de 70 atributos SMART mapeados, mas a maioria serve apenas para fins de engenharia. A empresa de cloud storage Backblaze, ao analisar dezenas de milhares de discos em seus data centers, identificou que apenas cinco métricas são fortes preditores de falha em HDDs. A análise revelou que 76,7% dos discos que falharam apresentaram um valor bruto (RAW) maior que zero em pelo menos um desses atributos antes de morrerem.
O consenso da área técnica dita tolerância zero para os seguintes identificadores:
- Atributo 5 (Reallocated Sectors Count): O disco encontrou um setor defeituoso de forma irreversível (bad block), isolou a área e moveu os dados para um setor de reserva. Qualquer número acima de zero aqui indica degradação física da superfície magnética.
- Atributo 187 (Reported Uncorrectable Errors): Erros de leitura que não puderam ser corrigidos pelo hardware ECC (Error Correction Code) interno da unidade.
- Atributo 188 (Command Timeout): Indica a quantidade de operações abortadas devido a lentidão na resposta do disco, geralmente apontando para problemas de cabo, interface ou controladora.
- Atributo 197 (Current Pending Sector Count): Setores marcados como "instáveis" após erros de leitura. Se uma gravação subsequente falhar, eles viram setores realocados (Atributo 5).
- Atributo 198 (Offline Uncorrectable): Semelhante ao 187, mas detectado durante verificações de diagnóstico offline.
O peso estatístico desses erros é massivo. Um estudo referencial do Google demonstrou que, nos 60 dias seguintes ao primeiro erro incorrigível (Atributo 198) detectado, o disco apresenta uma probabilidade 39 vezes maior de falhar em comparação a uma unidade limpa.
Atributos SMART em SSDs: Mudança de Foco
Para as unidades de estado sólido (SSDs), a mecânica de falha é fundamentalmente diferente. Não há pratos giratórios ou cabeças de leitura; a vida útil é ditada pelo esgotamento dos ciclos de gravação e apagamento (P/E cycles) das células de memória NAND.
Ferramentas genéricas frequentemente interpretam mal os dados de SSDs. A recomendação técnica é focar em atributos específicos da arquitetura flash, como detalhado por publicações especializadas como o XDA Developers:
- Wear Leveling Count: Mede o desgaste geral das células. SSDs distribuem as gravações uniformemente para evitar que uma célula morra antes das outras.
- Erase Fail Count: Indica quantas vezes a controladora falhou ao tentar apagar um bloco de dados na memória flash, um sinal claro de degradação da NAND.
Quando um SSD entra em falha crítica de gravação, a controladora muitas vezes o trava em modo "somente leitura". Diferente dos HDDs, a mecânica de exclusão de dados em flash, onde o TRIM torna quase impossível a recuperação posterior, exige monitoramento preventivo rigoroso da saúde da unidade.
Mitos e Controvérsias no Diagnóstico de Discos
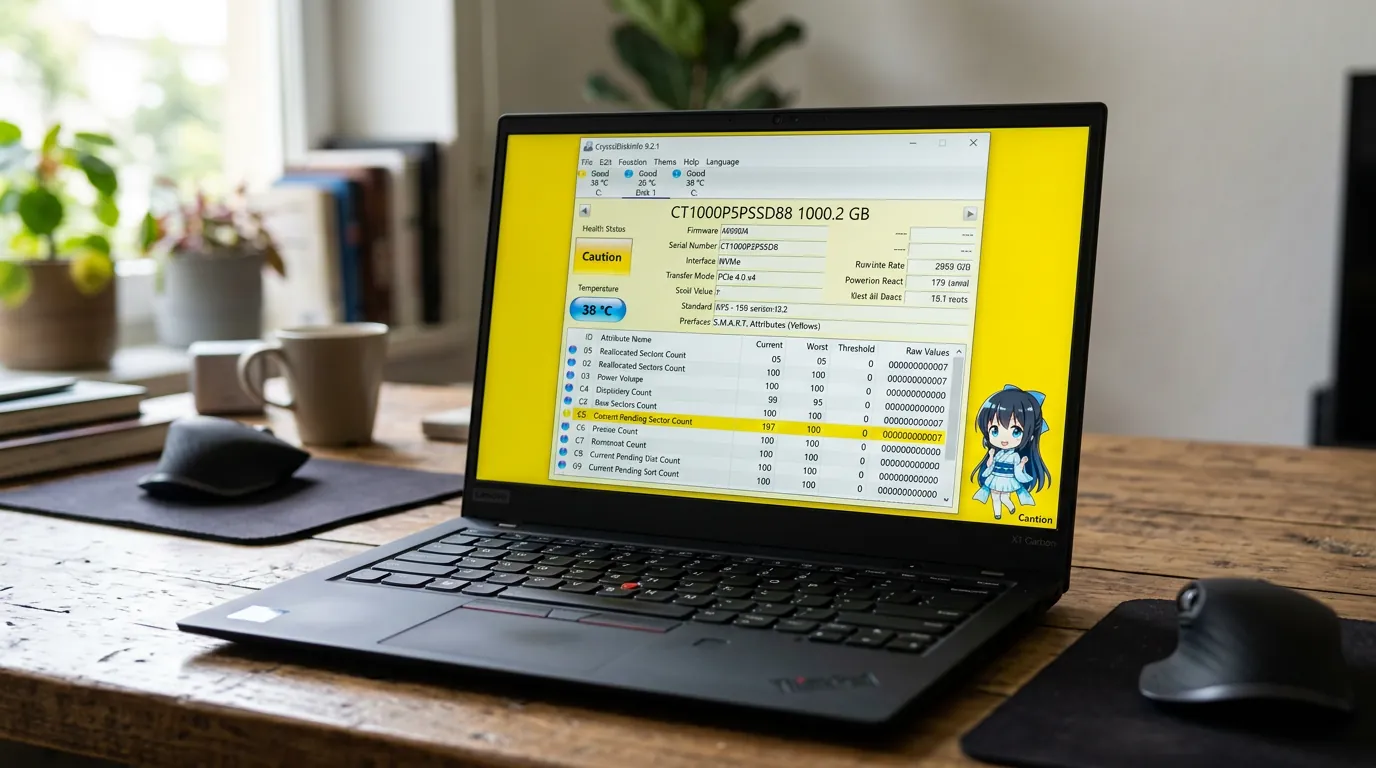
A interpretação dos dados SMART está cercada de desinformação. O mito mais perigoso é a crença de que o status "Saudável" ou "Good" no cabeçalho do software garante a integridade da unidade. Como visto na estatística de falhas súbitas, esse status é apenas um indicativo de que os limites predefinidos pelo fabricante (thresholds) ainda não foram ultrapassados.
Outra controvérsia histórica envolve a temperatura (Atributo 194). Por muito tempo, acreditou-se que temperaturas ligeiramente elevadas reduziam drasticamente a vida útil dos HDDs. No entanto, estudos de larga escala do Google e da Backblaze encontraram pouca ou nenhuma correlação direta entre o calor operacional moderado e o aumento nas taxas de falha, desmentindo o pânico generalizado sobre refrigeração extrema de discos rígidos.
Da mesma forma, as horas de uso (Atributo 9 - Power-On Hours) e os ciclos de energia (Atributo 12 - Power Cycle Count) apresentam correlação fraca com a falha iminente. O fenômeno da "mortalidade infantil" na eletrônica significa que discos novos podem falhar rapidamente, enquanto unidades antigas podem rodar por anos sem apresentar um único setor realocado.
Por fim, é vital entender que softwares não consertam hardware. Ferramentas do sistema operacional como o chkdsk ou formatações de baixo nível podem forçar o disco a remapear setores pendentes, zerando o Atributo 197 e incrementando o Atributo 5. Isso mascara o alerta temporariamente, mas o dano físico na superfície magnética é irreversível e tende a se propagar. O uso de ferramentas como o ddrescue para clonagem imediata é a única ação segura quando os atributos críticos começam a subir.
Perguntas Frequentes
O que significa o status SMART "Bad" ou "Falha" na BIOS?
Significa que um ou mais atributos críticos ultrapassaram o limite de tolerância estabelecido pelo fabricante no firmware do disco. A falha total da unidade é iminente. A recomendação técnica é não tentar reparar o disco, mas sim realizar backup imediato dos dados e substituir o hardware.
Por que softwares diferentes mostram valores SMART diferentes?
Não existe uma norma universal que obrigue os fabricantes a reportarem os valores brutos (RAW) da mesma maneira. Um atributo reportado pela Seagate pode ter uma estrutura hexadecimal completamente diferente da utilizada pela Western Digital, o que faz com que softwares genéricos de leitura interpretem os dados incorretamente e gerem falsos positivos.
É possível zerar ou resetar o histórico SMART de um disco?
Não por meios convencionais. Os dados SMART são gravados em uma área de serviço protegida nos pratos magnéticos (ou na NAND, no caso de SSDs), inacessível ao sistema operacional. Apenas equipamentos caros e específicos de laboratórios de recuperação de dados podem manipular essa área, e fazê-lo não reverte o dano físico que causou os erros.
Fontes
- Backblaze — What SMART Stats Tell Us About Hard Drives: https://www.backblaze.com/blog/what-smart-stats-indicate-hard-drive-failures/
- Wikipedia — S.M.A.R.T.: https://en.wikipedia.org/wiki/S.M.A.R.T.
- XDA Developers — 5 S.M.A.R.T. attributes that actually predict HDD and SSD failure: https://www.xda-developers.com/smart-attributes-predict-hdd-ssd-failure/
- Rossmann Group — What are the most critical SMART attributes for hard drive failure?: https://rossmanngroup.com/what-are-the-most-critical-smart-attributes-for-hard-drive-failure/
- Horizon Technology — A Brief History Of Self-Monitoring Technology: https://www.horizontechnology.com/news/smart-hard-drive-failure/


0 Comentários