

Animar uma foto com inteligência artificial e transformar uma imagem estática em vídeo consiste em carregar uma fotografia ou ilustração como quadro-chave (keyframe) em um modelo Image-to-Video (I2V) — como Google Veo 3.1, Kling 4.0, Runway Gen-4.5 ou HeyGen Avatar IV — e instruir, por meio de um comando curto de texto ou arquivo de áudio, apenas a ação do sujeito, o movimento da câmera e o som ambiente desejado. Diferentemente da geração puramente por texto, partir de uma imagem pronta garante controle total sobre iluminação, rosto e cenário antes de dar vida e física à cena.
Principais Aprendizados
- Escolha por objetivo: Use Google Veo 3.1, Kling 4.0 ou Runway Gen-4.5 para cenas cinematográficas com física e som nativo; HeyGen Avatar IV ou Hedra para fotos falantes (lip-sync); e Runway Act-Two para transferir expressões da sua webcam para um retrato.
- Regra de ouro do prompt: Nunca descreva o que já está visível na foto (roupas, cores ou cenário); descreva exclusivamente o movimento do personagem, a dinâmica do ambiente e o deslocamento da câmera.
- Mudança no mercado em 2026: O OpenAI Sora foi oficialmente descontinuado entre abril e setembro de 2026; o fluxo profissional atual apoia-se em múltiplos keyframes (quadro inicial e final) e áudio sincronizado na mesma renderização.
Por Que Transformar Imagem em Vídeo (I2V) Virou o Padrão da Produção com IA?
O consenso técnico na produção audiovisual contemporânea aponta que gerar vídeos diretamente de comandos de texto (Text-to-Video) gera alto desperdício de créditos e pouca previsibilidade estética. Na prática, o fluxo híbrido — no qual o criador fotografa ou gera a imagem perfeita primeiro para aprovar a direção de arte e só então aplica a animação guiada por quadro-chave — consolidou-se como o método mais eficiente para manter a consistência temporal de personagens e produtos.
Um ponto fundamental para quem busca ferramentas atualizadas em outubro de 2026 é ignorar listas antigas que ainda recomendam o gerador da OpenAI. Segundo comunicado oficial do OpenAI Help Center, a linha OpenAI Sora (incluindo o Sora 2) foi totalmente descontinuada: o aplicativo móvel e a versão web foram encerrados em 26 de abril de 2026, e a API foi desligada em 24 de setembro de 2026, após relatórios de mercado apontarem um custo operacional de cerca de US$ 1 milhão por dia frente a uma base inferior a 500 mil usuários ativos. Hoje, o estado da arte está concentrado em modelos multimodais capazes de gerar movimento realista e áudio sincronizado em uma única etapa.
Qual IA Escolher? As 3 Categorias Para Animar Fotos em 2026
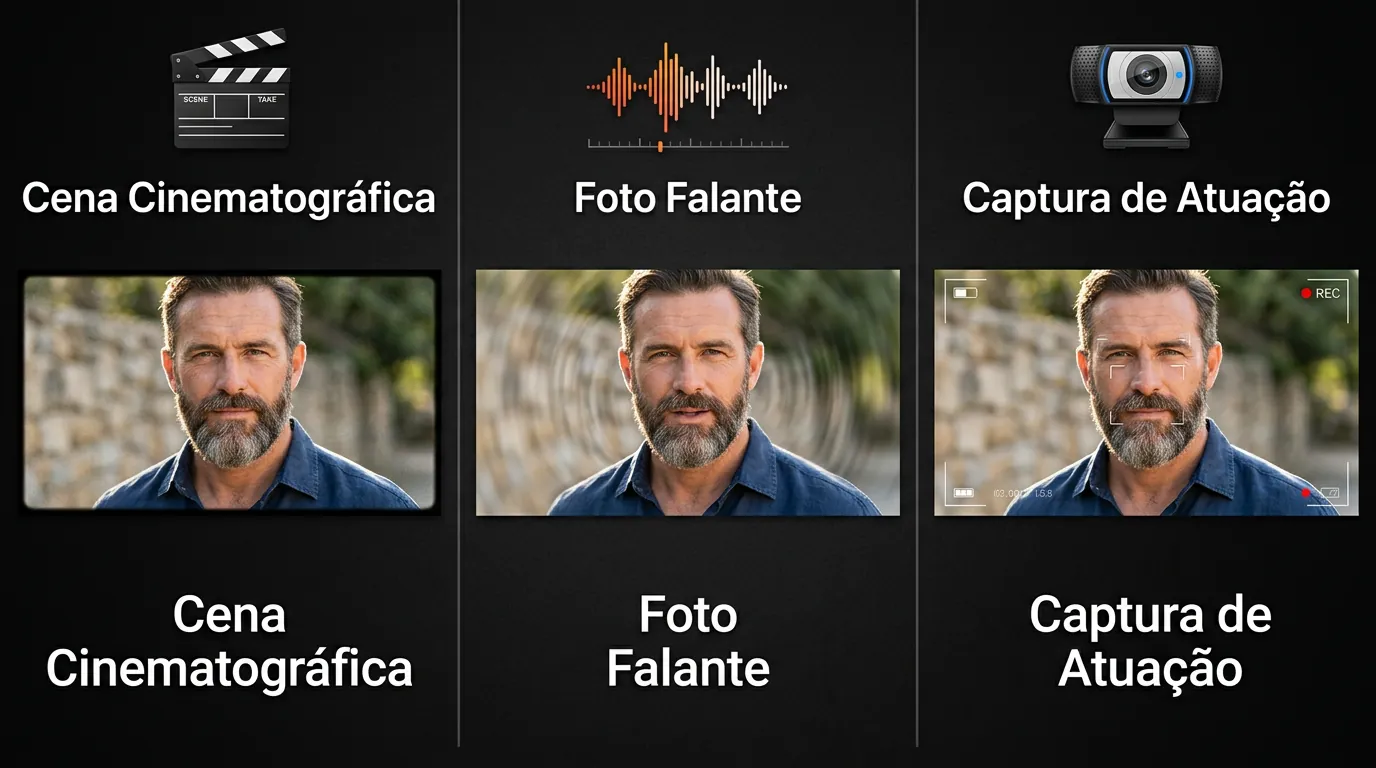
Não existe um único modelo que resolva todas as necessidades de animação. A recomendação técnica é selecionar a plataforma de acordo com uma das três categorias funcionais abaixo:
1. Geração Cinematográfica de Imagem para Vídeo (Com Física e Áudio Nativo)
Nesta modalidade, a sua foto funciona como o primeiro quadro (first frame), o último quadro (last frame) ou uma sequência de pontos de ancoragem. A inteligência artificial calcula a profundidade 3D da fotografia, movimenta elementos naturais como vento, água, fumaça e expressões sutis, executa movimentos de câmera profissionais e já sintetiza efeitos sonoros (Foley), trilha e diálogos sincronizados.
- Kling 4.0 (Kuaishou): Lançado oficialmente em 15 de outubro de 2026, o modelo elevou o teto técnico da categoria. De acordo com as especificações técnicas compiladas pelo portal Anikuku, o Kling 4.0 gera vídeos nativos de até 30 segundos em uma única execução, com resolução até 4K em 10-bit HDR, áudio estéreo de dois canais e controle de até 10 keyframes. Seu recurso Omni Reference aceita até 15 arquivos combinados (até 10 imagens, 5 vídeos e 7 sujeitos) para manter fidelidade absoluta do personagem.
- Google Veo 3.1 e Veo 3.1 Lite: Disponível no ecossistema Gemini e no Vertex AI, a família Veo superou a marca de 70 milhões de vídeos criados logo nos primeiros meses após sua estreia em 2025, segundo o Google Developers Blog. O modelo Veo 3.1 gera clipes de 4, 6 ou 8 segundos em até 4K com diálogos sincronizados a 48kHz e suporte a até 3 imagens de referência. Já o Veo 3.1 Lite, lançado em 31 de março de 2026, reduziu o custo de geração em mais de 50% em relação ao modo Fast. Para quem já explora recursos como o Modo IA do Google no dia a dia, a integração via Gemini torna a animação de fotos extremamente acessível.
- Runway Gen-4 e Gen-4.5: Sucessores da linha Gen-3 Alpha, os modelos Gen-4 (março de 2025) e Gen-4.5 (dezembro de 2025) destacam-se pelo controle espacial. A ferramenta conta com o Motion Brush Pro 2.0, um pincel vetorial que permite pintar exatamente qual área da foto deve se mover (como as nuvens ou a roda de um carro) e qual deve permanecer estática.
- Luma Dream Machine (Ray 2 e Ray 2 Flash): Treinado com 10 vezes mais capacidade computacional que a geração anterior, o modelo Ray 2 gera clipes de 10 segundos com simulação física avançada, criação de loops contínuos e versão Flash três vezes mais rápida.
- Pika 2.2 e Pika 2.5: Produz vídeos de até 10 segundos em 1080p Full HD a partir de fotos e introduziu o sistema Pikaframes, que permite interpolar de 2 a 5 imagens ordenadas com transições personalizáveis de 1 a 10 segundos.
2. Fotos Falantes e Avatares Guiados por Áudio (Talking Photos / Lip-Sync)
Se o objetivo é pegar um retrato corporativo, uma foto histórica ou um mascote ilustrado e fazê-lo recitar um roteiro completo, os modelos cinematográficos acima não são os mais indicados. Para sincronia labial longa, utilizam-se motores guiados por voz:
- HeyGen (Avatar IV e Avatar V): Conforme a documentação oficial da HeyGen, o modelo Avatar IV possui 18 bilhões de parâmetros (portado em agosto de 2026 para TPUs Google Cloud Trillium com ganho de velocidade de 1,86x) e é capaz de animar uma única foto — mesmo inclinada ou de perfil — em mais de 175 idiomas, gerando microexpressões faciais e gestos naturais de mãos alinhados à emoção da fala. Já o Avatar V, lançado em abril de 2026, foca em gêmeos digitais (Digital Twins) hiper-realistas. É um recurso amplamente combinado com ferramentas de IA para fazer slides em treinamentos e apresentações comerciais.
- Hedra: Especializada em avatares expressivos guiados por áudio, permite enviar qualquer imagem de personagem junto a uma faixa de voz cantada ou falada para obter atuação facial sincronizada. Caso você tenha gravado uma locução espontânea pelo celular, vale primeiro transcrever áudio em texto para revisar o roteiro ou gerar legendas precisas antes de exportar o vídeo final.
3. Transferência de Performance por Vídeo e Modelos Locais (Open-Source)
Quando o criador precisa de controle absoluto sobre cada piscada, sorriso e movimento de dedos, entra em cena a captura de movimento por vídeo (Video-Driven Motion Capture). Lançado em 15 de julho de 2025, o Runway Act-Two permite gravar até 30 segundos de atuação simples na webcam ou smartphone e transferir exatamente os movimentos de cabeça, olhos, boca, tronco e mãos do ator real para qualquer foto ou ilustração de personagem.
Por outro lado, usuários avançados que preferem animar fotos no próprio computador sem pagar assinaturas em nuvem contam hoje com fluxos locais no ComfyUI. Os destaques de pesos abertos são o Wan 2.1 (com variantes de 1.3B e 14B parâmetros e evoluções até a linha Wan 2.5/3.0), o HunyuanVideo da Tencent (geração a 24 FPS de 49 a 121 quadros) e o LTX-Video (capaz de renderizar a 24 FPS mais rápido que o tempo real em hardware dedicado). Graças às versões quantizadas em FP8 e GGUF Q8_0, esses modelos rodam em placas de vídeo domésticas — um critério essencial ao avaliar qual notebook comprar em 2026 caso o foco seja edição e inteligência artificial local.
Passo a Passo: Como Animar uma Foto com IA Sem Deformar a Imagem
Independentemente da plataforma escolhida, o método técnico abaixo em quatro etapas evita os defeitos visuais mais comuns (como rostos desfigurados ou objetos derretendo ao longo do clipe):
Passo 1: Preparação e Upscale da Fotografia Base
Os modelos Image-to-Video tratam a imagem enviada como verdade absoluta (ground truth). Se a foto original estiver borrada, escura ou apresentar falhas anatômicas, a IA vai animar e amplificar esses defeitos. Antes de enviar o arquivo:
- Restaure e aumente a nitidez (upscale) de fotos antigas ou de baixa resolução.
- Recorte a imagem exatamente na proporção do vídeo final: 16:9 (horizontal para YouTube e TV) ou 9:16 (vertical para Reels, TikTok e Shorts).
Passo 2: Ancoragem por Quadro Inicial e Final (Keyframes)
Em animações livres de 5 a 10 segundos, o personagem pode perder a semelhança facial nos segundos finais. Para evitar isso, utilize o recurso de First & Last Frame (disponível no Kling 4.0, Pika 2.5 e Luma Ray 2). Envie a sua foto principal como quadro inicial e uma segunda foto (com a pose final desejada) como último quadro. A IA criará a ponte perfeita entre as duas imagens.
Passo 3: A Fórmula do Prompt de Movimento
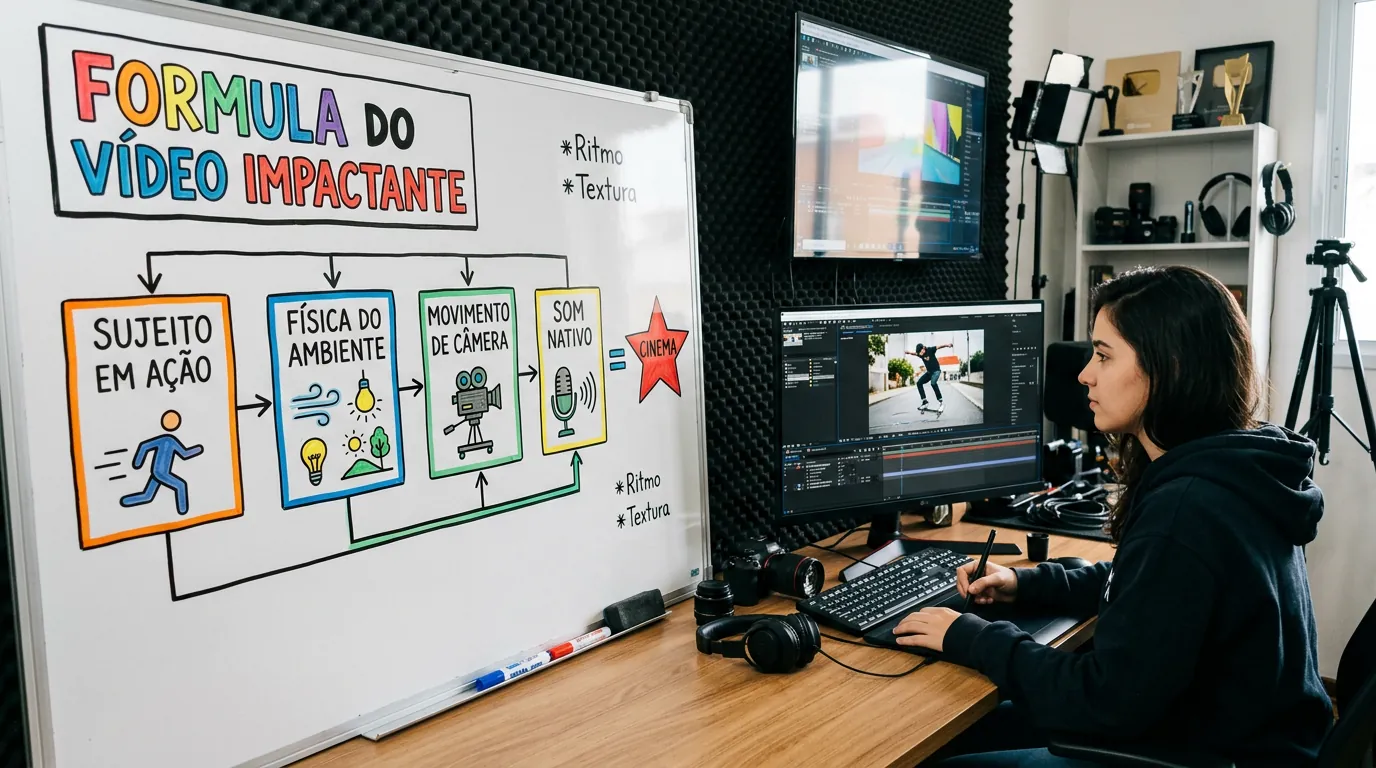
Quando você carrega uma foto, o sistema de visão computacional já enxerga todas as cores, roupas e objetos presentes. Portanto, não descreva a aparência da imagem no prompt. Utilize a seguinte estrutura enxuta:
[Ação simples do sujeito] + [Dinâmica do ambiente/física] + [Movimento de câmera] + [Áudio desejado]
- Exemplo do que NÃO fazer (Errado): "Foto de uma mulher de casaco vermelho na floresta com neve olhando para a câmera em alta resolução." (Isso força a IA a redesenhar o casaco e a neve por cima da foto, gerando perda de nitidez).
- Exemplo do que FAZER (Correto): "Ela sorri suavemente e pisca enquanto flocos de neve caem devagar ao fundo. Câmera faz um movimento lento de dolly in em direção ao rosto. Som suave de vento frio e passos na neve."
Passo 4: Controle de Região e Geração
Se apenas um elemento da foto deve se mexer (por exemplo, a fumaça de uma xícara de café enquanto a pessoa permanece imóvel), utilize o pincel de movimento (como o Motion Brush Pro 2.0 na Runway) para isolar a área ativa antes de clicar em gerar.
Erros Comuns Que Estragam a Animação (e Como Evitar)
Mesmo nas plataformas mais avançadas de 2026, três falhas de direção comprometem o resultado final:
- Pedir múltiplas ações sequenciais em um clipe curto: Solicitar que o personagem "abra a porta, caminhe até a mesa, sente-se na cadeira e beba água" em um vídeo de 5 a 8 segundos força o modelo a acelerar a física de maneira antinatural, deformando braços e objetos. A regra prática é limitar cada geração de 5 segundos a uma única ação contínua (ou usar múltiplos keyframes em gerações longas de 10 a 30 segundos no Kling 4.0).
- Usar modelos cinematográficos para discursos longos: Tentar fazer uma foto falar um parágrafo inteiro no Luma Ray 2 ou no Pika 2.5 gera movimentos labiais desconexos. Para falas extensas, migre para o HeyGen Avatar IV ou Runway Act-Two.
- Ignorar os comandos técnicos de câmera: Termos claros como pan left (giro horizontal para a esquerda), tilt up (inclinação vertical para cima), dolly in (aproximação física da câmera) e orbit (giro ao redor do sujeito) orientam o motor 3D com muito mais precisão do que instruções vagas como "mova a câmera de forma bonita".
Direitos de Imagem, Ética e Regras Legais para Deepfakes
Transformar retratos de pessoas reais em vídeos hiper-realistas exige responsabilidade ética e atenção às normas jurídicas internacionais. No âmbito regulatório, a Comissão Europeia colocou em vigor, em 2 de agosto de 2026, as regras de transparência do Artigo 50 do EU AI Act (Regulamento (UE) 2024/1689), após publicar suas diretrizes finais em 20 de julho de 2026.
A legislação determina que plataformas de IA insiram marcações detectáveis por máquina — como metadados de proveniência C2PA Content Credentials e marcas d'água invisíveis (a exemplo do SynthID do Google) — e obriga criadores profissionais e empresas a rotularem de forma clara e visível qualquer deepfake (animação verossímil de pessoas, locais ou eventos reais). O descumprimento corporativo está sujeito a multas de até 15 milhões de euros ou 3% do faturamento global anual (com prazo de adequação até 2 de dezembro de 2026 para sistemas lançados antes de agosto de 2026).
Além do aspecto legal, permanecem em aberto três debates importantes no setor audiovisual:
- Risco de dependência de plataforma (Vendor Lock-in): O desligamento do Sora em 2026 demonstrou que o altíssimo custo computacional do vídeo em nuvem pode levar ao encerramento de APIs proprietárias, incentivando estúdios a manterem fluxos alternativos em modelos abertos como Wan e HunyuanVideo.
- Direitos autorais e segurança comercial: Enquanto grandes modelos generalistas enfrentam questionamentos sobre o uso de acervos da web em seus treinamentos, cresce a demanda corporativa por modelos treinados exclusivamente em catálogos licenciados (como o modelo Marey, da Moonvalley) para evitar riscos jurídicos em campanhas publicitárias.
- Fragilidade das marcas d'água e ética memorial: Especialistas em segurança apontam que metadados C2PA ainda são frequentemente removidos quando o vídeo é recompactado por redes sociais e apps de mensagens. Paralelamente, a chamada "ressurreição digital" — animar fotos de parentes falecidos com voz e gestos — divide psicólogos e juristas entre o valor afetivo de memória e os limites dos direitos póstumos de personalidade.
Perguntas Frequentes
Qual a melhor IA para animar fotos grátis ou online em 2026?
Para cenas cinematográficas com movimento natural e som, os destaques atuais são o Google Veo 3.1 (e Veo 3.1 Lite), o Kling 4.0, o Runway Gen-4.5, o Luma Ray 2 e o Pika 2.5, muitos dos quais oferecem créditos iniciais gratuitos de teste. Para quem possui um computador com placa de vídeo dedicada e busca geração 100% gratuita e ilimitada, a melhor opção é rodar modelos de código aberto como Wan 2.1, HunyuanVideo ou LTX-Video localmente pelo ComfyUI.
Como fazer uma foto falar ou cantar com inteligência artificial?
Para fazer um retrato falar ou cantar com sincronia labial precisa (lip-sync), utilize ferramentas guiadas por áudio ou captura de performance em vez de geradores de vídeo comuns. O HeyGen Avatar IV (que suporta mais de 175 idiomas e gera gestos de mãos coordenados com a voz) e a plataforma Hedra permitem enviar uma foto e um arquivo de áudio ou texto, enquanto o Runway Act-Two transfere a sua própria atuação gravada na webcam para a foto.
O que aconteceu com o OpenAI Sora para transformar imagem em vídeo?
O OpenAI Sora e o Sora 2 foram oficialmente descontinuados pela OpenAI em 2026 devido aos elevados custos computacionais (estimados em US$ 1 milhão por dia) e à queda na retenção de usuários. O aplicativo e a versão web foram encerrados em 26 de abril de 2026, e a API foi desligada em 24 de setembro de 2026. Hoje, os substitutos diretos mais avançados são o Google Veo 3.1, o Kling 4.0 e o Runway Gen-4.5.
Fontes
- OpenAI Help Center — Sora Discontinuation FAQ
- Google Developers Blog — Veo 3, Veo 3 Fast and Image-to-Video in Gemini API
- BuildFastWithAI — Google Veo 3.1 & Veo 3.1 Lite Complete Guide
- Anikuku — Kling 4.0 Official Announcement & Specifications
- Runway Official — AI Lip Sync & Act-Two Categories
- Getimg.ai — Runway Video Model Timeline (Gen-1 to Gen-4.5)
- Pika.art Official — Pika 2.5 Image-to-Video Playground
- Luma Labs Official — What is Ray 2 & Ray 2 Flash
- HeyGen Official — Photo Avatar, Avatar IV and Avatar V Comparison
- Hedra Official — How AI Lip Sync Technology Works
- ComfyUI Official Blog — Wan 2.1, Hunyuan Image-to-Video and LTXV Workflows
- Comissão Europeia (Europa.eu) — AI Act Transparency Code & Article 50
- Paul, Weiss — EU Commission Finalises Guidelines on Article 50 AI Act


0 Comentários